Мы добавили распознавание и генерацию изображений
Мы продолжаем расширять возможности нашей ИИ-системы, изначально ориентированной на работу с инфраструктурой и инженерными задачами.
Ранее система уже умела:
- работать с серверами через SSH — выполнять команды, анализировать вывод и пошагово решать задачи;
- взаимодействовать с Telegram (чаты и каналы);
- работать с облачной Jira;
- использовать встроенный Browser с ИИ для анализа веб-ресурсов.
Теперь в систему добавлена работа с изображениями.
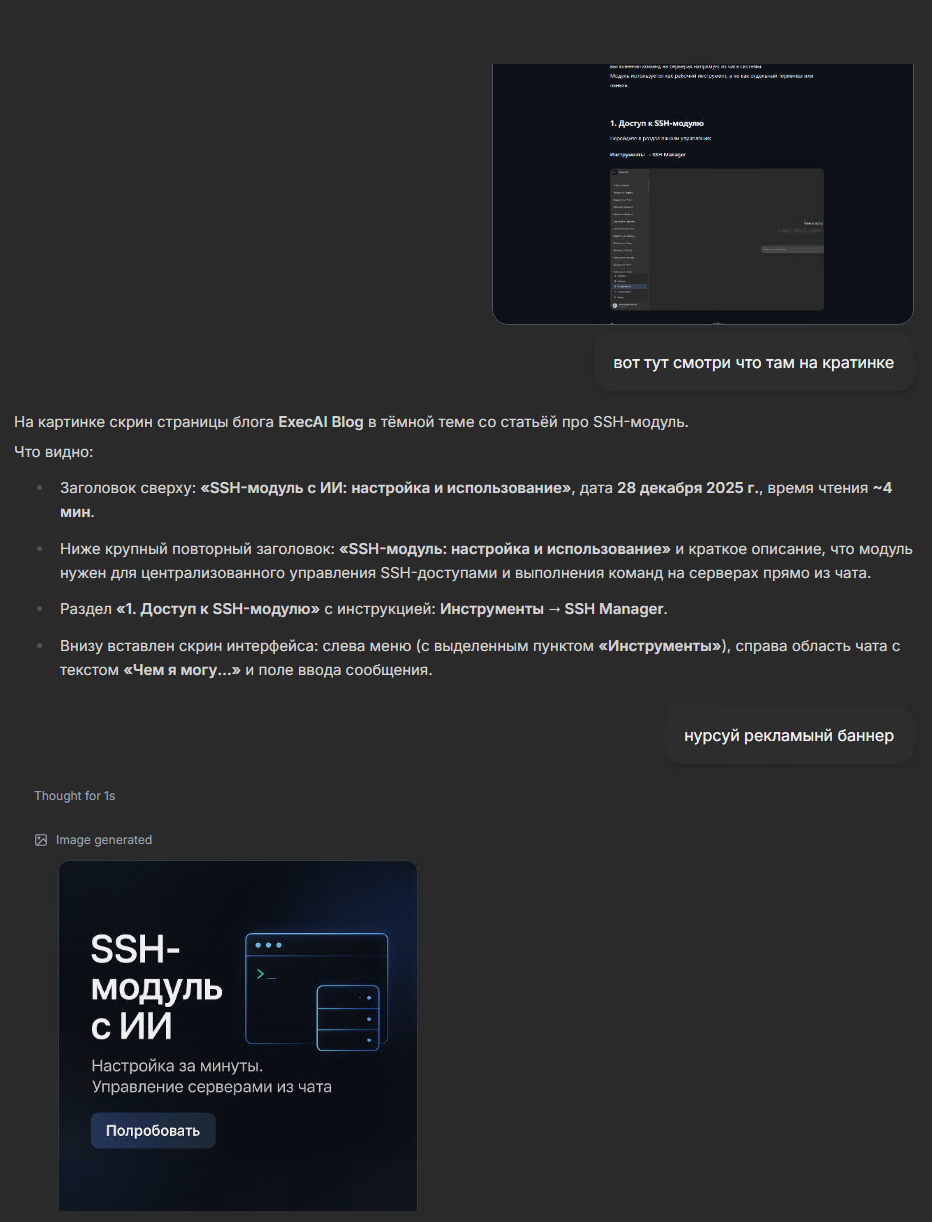
Что именно появилось
На данный момент ИИ умеет:
-
распознавать изображения и скриншоты
Анализировать:- интерфейсы и UI;
- логи на скриншотах терминалов;
- схемы и диаграммы;
- визуально представленные ошибки и состояния систем.
-
генерировать изображения
Генерация используется как рабочий инструмент:- схемы и визуальные пояснения;
- иллюстрации;
- технические и концептуальные изображения.
Речь идёт не о генерации «картинок ради картинок», а о визуальных артефактах, используемых в рабочих процессах.
Сквозная работа между модулями (в разработке)
Следующий шаг, над которым мы сейчас работаем, — использование сгенерированных изображений в других модулях системы.
Планируемая логика работы:
- ИИ генерирует изображение;
- результат становится доступным другим инструментам системы.
Примеры сценариев:
- сгенерировать изображение и опубликовать его в Telegram-канале через Telegram ИИ-модуль;
- сгенерировать изображение и загрузить его на сервер или сайт через SSH-модуль;
- использовать изображения как часть отчётов, документации или автоматизированных действий.
Таким образом изображения становятся не конечным результатом, а частью общего рабочего пайплайна.
Как это вписывается в архитектуру системы
Наша система строится вокруг идеи, что ИИ:
- работает с реальными инструментами (SSH, Jira, Telegram, Browser);
- получает контекст из разных источников;
- анализирует результаты своих действий;
- и теперь — работает с визуальными данными наравне с текстом и stdout команд.
Изображения становятся ещё одним типом данных, с которым ИИ может:
- анализировать;
- преобразовывать;
- использовать в дальнейших действиях.
Текущее состояние
На данный момент:
- распознавание и генерация изображений доступны для OpenAI;
- функциональность уже интегрирована в систему.
Мы уже ведём работы по внедрению этого механизма для всех омнимабольных моделей, используемых в системе, чтобы работа с изображениями была единообразной независимо от выбранного backend’а.
Зачем мы это делаем
Мы последовательно движемся к системе, где ИИ:
- работает с любыми типами данных: текст, команды, API, интерфейсы, изображения;
- не требует ручного переключения контекста;
- используется как инструмент для решения реальных задач, а не как отдельный чат.
Сквозная работа с изображениями — логичное продолжение этого подхода.
Что дальше
В ближайших шагах:
- интеграция изображений в другие модули;
- расширение поддержки моделей;
- развитие сценариев, где визуальные данные участвуют в автоматизации и инженерных процессах.
Мы продолжаем развивать систему не по принципу количества функций, а по принципу практической применимости.